01b Fiche méthode - Tri par insertion
📌 Le principe
⚓︎
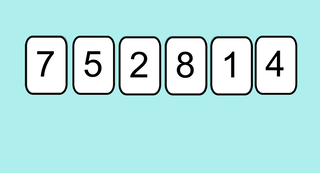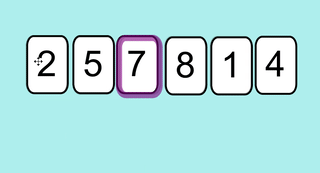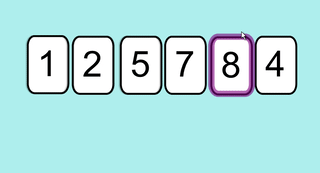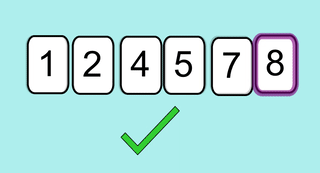
Le travail se fait essentiellement sur les indices.
On considère que le premier élément est déjà trié.
🔁 Pour chaque nouvel élément (à partir de l’indice 1), on le compare aux éléments précédents :
- Tant qu’il est plus petit, on décale les éléments vers la droite.
- Puis, on insère cet élément à la bonne place.
Ce tri fonctionne un peu comme si tu voulais classer tes cartes en main dans l’ordre croissant !
⚙️ L’algorithme
⚓︎
💻 Script Python
⚓︎
def tri_insertion(T):
    for i in range(1, len(T)):
        j = i
        val = T[i]
        while j > 0 and val < T[j - 1]:
            T[j] = T[j - 1]
            j = j - 1
        T[j] = val
    return T
🧪 Vérification
⚓︎
a = [7, 5, 2, 8, 1, 4]
tri_insertion(a)
print(a)
❓Tester ce qui est proposé
📈 Complexité de l’algorithme
⚓︎
🔬 Observation expérimentale
⚓︎
Étudions la durée moyenne pour trier une liste de 100 puis de 1 000 éléments, dans le pire des cas (liste triée à l’envers).
Ajoute ce script :
import time

somme_des_durees = 0
for i in range(5):
    a = [k for k in range(100 - 1, -1, -1)]
    start_time = time.time()
    tri_insertion(a)
    somme_des_durees += time.time() - start_time
moyenne = somme_des_durees / 5
print("Temps d'exécution pour 100 : %s secondes ---" % moyenne)

somme_des_durees = 0
for i in range(5):
    b = [k for k in range(1_000 - 1, -1, -1)]
    start_time = time.time()
    tri_insertion(b)
    somme_des_durees += time.time() - start_time
moyenne = somme_des_durees / 5
print("Temps d'exécution pour 1_000 : %s secondes ---" % moyenne)
❓ Recopier le script du tri par insertion et tester le code ci-dessus. ⚠️ Cela peut prendre un peu de temps !
❓Tester ce qui est proposé
📊 Résultats constatés :
- Pour 1 000 : ~0.011 s
- Pour 10 000 : ~1.09 s
💡 Une liste 10× plus longue prend 100× plus de temps → complexité quadratique.
📚 Démonstration
⚓︎
Dans le pire des cas, pour une liste de taille n :
- La boucle
fors'exécuten-1fois. - La boucle
whiles’exécute 1 + 2 + … + (n-1) fois :
➡️ Complexité : 𝑂(n²)
⏱️ Résumé des complexités
⚓︎
-
✅ Meilleur des cas (liste déjà triée) : complexité linéaire → 𝑂(n) (on ne rentre jamais dans la boucle
while) -
❌ Pire des cas (liste triée à l’envers) : complexité quadratique → 𝑂(n²)
🧠 Remarque : le tri par insertion est plus efficace que le tri par sélection si la liste est partiellement triée.
🔐 Preuve de l’algorithme
⚓︎
✔️ Preuve de terminaison
⚓︎
L’algorithme contient :
- une boucle
forbien délimitée, - une boucle
whileavec condition :
while j > 0 and l[j - 1] > val:
📌 À chaque tour de boucle while, la variable j diminue d’1
➡️ Elle devient forcément nulle au bout d’un moment → sortie garantie
La variable j est un variant de boucle : elle garantit que la boucle ne tourne pas indéfiniment.
✅ Preuve de la correction
⚓︎
On utilise un raisonnement par récurrence :
🧩 Propriété : « Au début de l’itération d’indice i, le sous-tableau T[ : i] est trié. »
🎯 Cette propriété est un invariant de boucle, elle reste vraie à chaque étape.
- Initialisation : pour
i = 1,T[ : 1]contient seulement le premier élément, il est donc trié. - Hérédité : on mémorise
T[i], on décale vers la droite les éléments précédents qui lui sont supérieurs, puis on l’insère à la bonne place. Le sous-tableauT[ : i+1]devient alors trié. - Terminaison : la dernière itération correspond à
i = n-1. Après cette itération,T[ : n], c’est-à-dire tout le tableau, est trié.
Pour s'entrainer : CODEX