01a Fiche méthode - Tri par sélection
🔍 Le principe
⚓︎
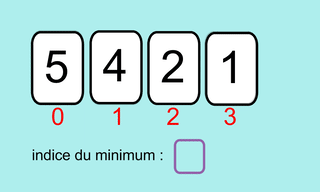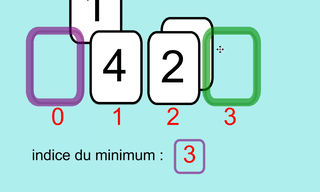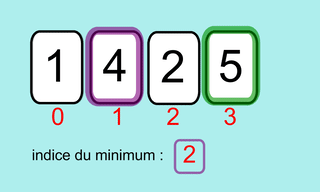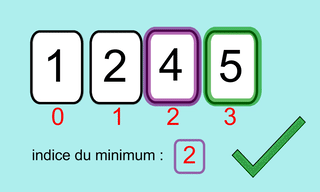
Le travail se fait essentiellement sur les indices.
On part de l’indice du premier élément et on considère que cet élément est le minimum.
👉 On parcourt les éléments suivants. Si on repère un élément plus petit que notre minimum, on garde en mémoire son indice.
📌 Une fois le parcours terminé, on échange l’élément de travail avec le minimum trouvé.
🔁 On recommence jusqu’à l’avant-dernier élément de la liste.
⚙️ L’algorithme
⚓︎
💻 Script Python
⚓︎
def tri_selection(T):
    for i in range(len(T) - 1):
        mini = i

        for j in range(i + 1, len(T)):
            if T[j] < T[mini]:
                mini = j

        if mini != i:
            T[i], T[mini] = T[mini], T[i]

    return T # non nécessaire
🔎 Vérification
⚓︎
# tester avec :
a = [7, 5, 2, 8, 1, 4]
tri_selection(a)
print(a)
❓Tester ce qui est proposé
📈 Complexité de l’algorithme
⚓︎
🔬 Observation
⚓︎
On va mesurer une moyenne de durée sur 5 exécutions avec deux tailles de listes, dans le pire des cas (liste décroissante).
Ajoute ce script :
import time

somme_des_durees = 0
for i in range(5):
    a = [k for k in range(100)]
    start_time = time.time()
    tri_selection(a)
    somme_des_durees += time.time() - start_time
moyenne = somme_des_durees / 5
print("Temps pour 100 : %s sec ---" % moyenne)

somme_des_durees = 0
for i in range(5):
    b = [k for k in range(1_000)]
    start_time = time.time()
    tri_selection(b)
    somme_des_durees += time.time() - start_time
moyenne = somme_des_durees / 5
print("Temps pour 1_000 : %s sec ---" % moyenne)
❓ Recopier le script du tri par sélection et tester le code ci-dessus. ⚠️ Cela peut prendre un peu de temps !
❓Tester ce qui est proposé
📊 En local, on trouve :
- Pour 1 000 : ~0.039 s
- Pour 10 000 : ~4.57 s
🧠 Conclusion : si on multiplie la taille par 10, le temps est multiplié par 100 → la complexité est quadratique.
📚 Démonstration
⚓︎
Dans le pire des cas, pour une liste de taille n :
- boucle
forextérieure :n-1tours - boucle intérieure : \((n-1)+(n-2)+\dots+1\) = \(\frac{n(n-1)}{2}\)
✅ Confirme que le tri par sélection est en 𝑂(n²).
✨ Complexité dans le meilleur des cas
Même si la liste est déjà triée, le tri par sélection :
- parcourt toujours l'intégralité des éléments restants pour trouver un minimum,
- effectue les mêmes comparaisons qu'en cas de liste en désordre,
- mais réalise moins d’échanges (voire aucun si les indices minimaux ne changent pas).
🔍 Ce qui change :
- ✅ Pas d'échange inutile si
mini == i - ❌ Mais toutes les comparaisons sont quand même faites
📌 Conclusion : Le meilleur des cas n’améliore pas significativement les performances :
🕒 Le nombre d’opérations reste proportionnel à \(n \times (n-1)/2\) 👉 La complexité est donc quadratique aussi dans le meilleur des cas : 𝑂(n²)
🧪 Preuve de l’algorithme
⚓︎
✔️ Preuve de la terminaison
⚓︎
L’algorithme ne contient que des boucles for bien définies :
il s’exécute toujours un nombre fini d’opérations.
➡️ Le nombre total d’itérations est : \(\frac{n(n-1)}{2}\) Donc le programme se termine toujours.
✅ Preuve de la correction
⚓︎
On utilise un raisonnement par récurrence :
🧩 Propriété : « Au début de l’itération d’indice i, le sous-tableau T[ : i] est trié et contient les i plus petits éléments du tableau. »
🎯 Cette propriété est un invariant de boucle, elle reste vraie à chaque étape.
- Initialisation : avant l’itération
i = 0,T[ : 0]est vide, donc trié. - Hérédité : l’algorithme cherche le minimum de
T[i : ], puis le place à l’indicei. Ainsi,T[ : i+1]est triée et contient lesi+1plus petits éléments. - Terminaison : après le traitement de l’avant-dernière position, le dernier élément restant est nécessairement le plus grand. Tout le tableau est donc trié.
Pour s'entrainer : CODEX