12 Traitement des données en tables
Table des matières
- LES FICHIERS CSV ET LES FICHIERS JSON
- IMPORTATION D’UN FICHIER CSV
- Analyse et Visualisation
- TRI
- FUSION DE TABLES
- PROJET (DEMARCHE D’INVESTIGATION)
1. Les fichiers CSV et les fichiers JSON
⚓︎
Les jeux de données en libre accès sont souvent fournis sous les formats suivants :
-
CSV (Comma Separated Values) : format simple de fichier texte structurant les données sous forme de tableau, où chaque ligne représente un enregistrement et chaque colonne une variable.
-
JSON (JavaScript Object Notation) : format structuré sous forme de paires clé-valeur, utilisé principalement pour les échanges de données entre applications.
1.1. Exemple de format CSV
⚓︎
Un fichier CSV contenant des albums de musique pourrait être structuré ainsi :
Album;Groupe;Année;Classement
Master of Puppets;Metallica;1986;1
Paranoid;Black Sabbath;1970;2
Rage Against the Machine;Rage Against the Machine;1992;3
Ride the Lightning;Metallica;1984;4
-
Les valeurs sont séparées par un point-virgule (
;), mais d'autres séparateurs comme la virgule (,) ou la tabulation (\t) existent. -
En France, le point-virgule (
;) est souvent utilisé contrairement à d'autres pays où la virgule prédomine.
1.2. Exemple de format JSON
⚓︎
L'équivalent en JSON du fichier précédent :
{
    "albums": [
        {"Album": "Master of Puppets", "Groupe": "Metallica", "Année": 1986, "Classement": 1},
        {"Album": "Paranoid", "Groupe": "Black Sabbath", "Année": 1970, "Classement": 2},
        {"Album": "Rage Against the Machine", "Groupe": "Rage Against the Machine", "Année": 1992, "Classement": 3},
        {"Album": "Ride the Lightning", "Groupe": "Metallica", "Année": 1984, "Classement": 4}
    ]
}
-
JSON est plus structuré et convient aux applications web et bases de données NoSQL.
-
Il permet d’imbriquer des objets et de gérer des types variés (nombres, chaînes de caractères, booléens, listes…).
2. Importation d’un fichier CSV
⚓︎
2.1. Lecture d'un fichier CSV en liste simple
⚓︎
🧠 Exercices dans Capytale => le code vous sera donné par votre enseignant
Activité n°1 : Lire un fichier CSV avec csv.reader
import csv

f = open("musique.csv", encoding="utf-8")  # Ouvre le fichier CSV avec encodage UTF-8
donnees = csv.reader(f, delimiter=';')  # Lecture avec séparateur ";"
for row in donnees:
    print(row)  # Affiche chaque ligne
f.close()  # Toujours fermer le fichier
Attention sur Thonny (par exemple) il faut enregistrer le fichier python au même endroit que le fichier CSV.
>>>
['Album', 'groupe', 'année', 'classement']
['Master of Puppets', 'Metalica', '1986', '1']
['Paranoid', 'Black Sabbath', '1970', '2']
['Rage against the machine', 'Rage against the machine', '1992', '3']
['Ride the lightning', 'Metallica', '1984', '4']
['Rust in peace', 'Megadeth', '1990', '5']
['Metallica', 'Metallica', '1991', '6']
['Toxicity', 'System of a down', '2001', '7']
['reign in blood', 'Slayer', '1986', '8']
['the number of the beast', 'Iron maiden', '1982', '9']
['From mars to sirius', 'Gojira', '2005', '10']
['..and justice for all', 'Metallica', '1988', '11']
['Mutter', 'Rammstein', '2001', '12']
['Painkiller', 'Judas Priest', '1990', '13']
['Powerslave', 'Iron maiden', '1984', '14']
['Blawater Park', 'Opeth', '2001', '15']
📝 Problème : Les données sont des listes non structurées. La première ligne correspond aux descripteurs, les autres lignes aux valeurs.
2.2. Lecture en liste de liste
⚓︎
Activité n°2 : Stocker un fichier CSV sous forme de liste de listes
import csv

table = []
with open("musique.csv", encoding="utf-8") as f:
    donnees = csv.reader(f, delimiter=';')
    for row in donnees:
        table.append(row)  # Ajoute chaque ligne à la liste table

print(table)  # Affichage de la liste de listes
>>>
[['Album', 'groupe', 'année', 'classement'], ['Master of Puppets', 'Metalica', '1986', '1'], ['Paranoid', 'Black Sabbath', '1970', '2'], ['Rage against the machine', 'Rage against the machine', '1992', '3'], ['Ride the lightning', 'Metallica', '1984', '4'], ['Rust in peace', 'Megadeth', '1990', '5'], ['Metallica', 'Metallica', '1991', '6'], ['Toxicity', 'System of a down', '2001', '7'], ['reign in blood', 'Slayer', '1986', '8'], ['the number of the beast', 'Iron maiden', '1982', '9'], ['From mars to sirius', 'Gojira', '2005', '10'], ['..and justice for all', 'Metallica', '1988', '11'], ['Mutter', 'Rammstein', '2001', '12'], ['Painkiller', 'Judas Priest', '1990', '13'], ['Powerslave', 'Iron maiden', '1984', '14'], ['Blawater Park', 'Opeth', '2001', '15']]
✅ Avantage : Structure en tableau facilitant l’accès aux données.
❌ Inconvénient : Il faut manipuler les indices (table[0], table[1]...) pour récupérer les données.
2.3. Lecture en liste de dictionnaires
⚓︎
Activité n°3 : Transformer un fichier CSV en liste de dictionnaires
import csv

dico = []
with open("musique.csv", encoding="utf-8") as f:
    donnees = csv.DictReader(f, delimiter=';')
    for row in donnees:
        dico.append(row)

print(dico)  # Affichage de la liste de dictionnaires
>>>
[{'Album': 'Master of Puppets', 'groupe': 'Metalica', 'année': '1986', 'classement': '1'}, {'Album': 'Paranoid', 'groupe': 'Black Sabbath', 'année': '1970', 'classement': '2'}, {'Album': 'Rage against the machine', 'groupe': 'Rage against the machine', 'année': '1992', 'classement': '3'}, {'Album': 'Ride the lightning', 'groupe': 'Metallica', 'année': '1984', 'classement': '4'}, {'Album': 'Rust in peace', 'groupe': 'Megadeth', 'année': '1990', 'classement': '5'}, {'Album': 'Metallica', 'groupe': 'Metallica', 'année': '1991', 'classement': '6'}, {'Album': 'Toxicity', 'groupe': 'System of a down', 'année': '2001', 'classement': '7'}, {'Album': 'reign in blood', 'groupe': 'Slayer', 'année': '1986', 'classement': '8'}, {'Album': 'the number of the beast', 'groupe': 'Iron maiden', 'année': '1982', 'classement': '9'}, {'Album': 'From mars to sirius', 'groupe': 'Gojira', 'année': '2005', 'classement': '10'}, {'Album': '..and justice for all', 'groupe': 'Metallica', 'année': '1988', 'classement': '11'}, {'Album': 'Mutter', 'groupe': 'Rammstein', 'année': '2001', 'classement': '12'}, {'Album': 'Painkiller', 'groupe': 'Judas Priest', 'année': '1990', 'classement': '13'}, {'Album': 'Powerslave', 'groupe': 'Iron maiden', 'année': '1984', 'classement': '14'}, {'Album': 'Blawater Park', 'groupe': 'Opeth', 'année': '2001', 'classement': '15'}]
✅ Avantage : Chaque ligne est convertie en dictionnaire avec des clés explicites.
❌ Inconvénient : Utilisation légèrement plus gourmande en mémoire.
3. Application : Analyse et Visualisation de données CSV
⚓︎
3.1. Tracer un graphique avec matplotlib
⚓︎
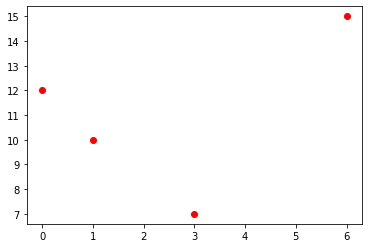
matplotlib📌 Exemple de graphique avec Matplotlib
import matplotlib.pyplot as plt

X = [0, 1, 3, 6]  # Liste des abscisses
Y = [12, 10, 7, 15]  # Liste des ordonnées

plt.plot(X, Y, 'ro')  # 'ro' = points rouges
plt.xlabel("Abscisse")
plt.ylabel("Ordonnée")
plt.title("Exemple de nuage de points")
plt.show()
-
plt.plot(X, Y, 'ro') affiche les points rouges.-
plt.show() affiche le graphique.
3.2. Analyse du fichier MetalBands.csv
⚓︎
MetalBands.csvLe nouveau fichier contient les descripteurs suivants :
- band_name,
- fans,
- formed,
- origin,
- style
Activité n°4 : Analyse de données CSV
import csv

dico = []
with open("MetalBands.csv", encoding='ISO-8859-1') as f:
    donnees = csv.DictReader(f, delimiter=',')
    for row in donnees:
        dico.append(row)
print(dico)
f.close()
- Quel est le nom du groupe en 812
encodage
Ici on utilise encoding='ISO-8859-1' car l'encoding est différent car les données sont anglo-saxonnes donc la virgule correspond à la convention internationale.
3.3. Recherche de groupes par année
⚓︎
Activité n°5
📌 Compter les groupes formés en 1981
📌 Explication :
-
On filtre les groupes avec
formed == '1981'. -
On affiche la taille de la liste filtrée.
3.4. Liste des groupes de "Melodic Death"
⚓︎
Activité n°6 :
📌 Donner la liste des groupes dont le genre est du ‘Melodic death’. Aide : il y a 275 groupe
📌 Attention :
-
il faut convertit en minuscule pour éviter les erreurs de casse.
-
set()supprime automatiquement les doublons.
3.5. Visualisation des groupes sur un graphique
⚓︎
Activité n°7 :
📌 Afficher sur un graphique tous les groupes de métal, en mettant l’année de formation en abscisse et le nombre de fans en ordonnée.
Attention à convertir les nombres en entier. Cela peut prendre un peu de temps
📌 Faire apparaitre ensuite (par-dessus) les groupes de ‘Melodic death’ en bleu (‘bo’) et les groupes de Heavy en vert (‘go’).
Attention aux majuscules, minuscules => pensez à tout mettre en minuscule
4.Filtre et Tri des données
⚓︎
L’exploitation des données passe souvent par un tri afin de faciliter la recherche et l’analyse des informations.
📌 Pourquoi trier ?
-
Obtenir un classement (exemple : tri des groupes de métal par popularité).
-
Optimiser les recherches (exemple : la recherche dichotomique est plus efficace sur un tableau trié).
4.1. Fonction filtre : rechercher un groupe selon son genre
⚓︎
Activité n°8 : fonction filtre
on travaillera avec le fichier metalbands.csv.
Créer une fonction groupeGenre() qui renvoie une liste contenant les fiches de tous les groupes de métal d’un genre passée en paramètre.
Exemple d'utilisation :
>>> print(groupeGenre('Extreme folk'))
[{'band_name': 'Ensiferum', 'fans': '1879', 'formed': '1995', 'origin': 'Finland', 'style': 'Extreme folk'},
{'band_name': 'Finntroll', 'fans': '967', 'formed': '1997', 'origin': 'Finland', 'style': 'Extreme folk'},
{'band_name': 'Brymir', 'fans': '108', 'formed': '2006', 'origin': 'Finland', 'style': 'Extreme folk'}]
4.2. Fonction de tri
⚓︎
On ne peut pas directement trier le tableau précédent… car cela ne veut rien dire. Il faut indiquer selon quels critères on veut effectuer ce tri. Pour cela, on appelle la fonction sorted() ou la méthode .sort() , avec l’argument supplémentaire key qui est une fonction renvoyant la valeur utilisée pour le tri.
Le tri permet d'ordonner les données selon un critère donné.
-
sorted()retourne une nouvelle liste triée. -
.sort()trie la liste en place (modifie la liste originale).
🔹 Exemple de tri d'un dictionnaire
Simpsons = [{"Prenom": "Bart", "age": "10"},
           {"Prenom": "Lisa", "age": "8"},
           {"Prenom": "Maggie", "age": "1"},
           {"Prenom": "Homer", "age": "38"},
           {"Prenom": "Marge", "age": "37"}]

def age(personnage):
    return int(personnage["age"])  # Conversion en entier

# Tri des personnages par âge croissant
triSimpsons = sorted(Simpsons, key=age)

# Tri par âge décroissant
triSimpsonsDesc = sorted(Simpsons, key=age, reverse=True)
Activité n°9 : Trier les groupes par nombre de fans (ordre décroissant)
🎯 Trier les noms des groupes par nombre de fans decroissants et afficher les groupes qui ont plus de 2000 fans.
📌 Aide : Il y a 13 groupes ayant plus de 2000 fans.
Activité n°10 : Trier les groupes par année de formation (1980-1985)
🎯 Trier les noms des groupes par année de formation et afficher les groupes qui se sont formés entre 1980 compris et 1985 compris.
📌 Aide : Il y a 240 groupes correspondant à ces critères.
5.Fusion de tables : Croisement des données CSV
⚓︎
On considère dans ce sujet les trois fichiers csv décrits ci-dessous : countries.csv contient des informations décrivant les pays :
-
CountryCode : le code du pays (texte, clé primaire)
-
Name : le nom du pays (texte)
-
Continent : le continent du pays (texte)
-
SurfaceArea : la surface du pays (nombre décimal)
-
Population : la population du pays (entier)
-
Capital : la capitale du pays (nombre entier correspondant à un ID dans le fichier cities.csv)
-
d'autres descripteurs qui ne nous intéressent pas ici...
languages.csv contient les informations sur les langues parlées dans chaque pays :
-
CountryCode : le code du pays (texte)
-
Language : la langue concernée par cette entrée (texte)
-
IsOfficial : cette langue est-elle officielle dans ce pays ? (texte, T pour True, F pour False)
-
Percentage : le pourcentage de locuteurs dans le pays (nombre décimal)
cities.csv contient des informations décrivant des villes :
-
ID : l'identifiant de la ville (entier)
-
Name : le nom de la ville (texte)
-
code : le code du pays dans lequel est situé la ville (texte)
-
District : la région d'appartenance de la ville (texte)
-
Population : la population de la ville (entier)
pays = [
    {"CountryCode": "ABW", "Name": "Aruba", "Continent": "North America", ...},
    {"CountryCode": "AFG", "Name": "Afghanistan", "Continent": "Asia", ...},
    ...
]

langues = [
    {"CountryCode" : "ABW", "Language": "Dutch", "IsOfficial": True, "Percentage": 5.3},
    {"CountryCode" : "ABW", "Language": "English", "IsOfficial": False, "Percentage": 9.5},
    ...
]

villes = [
    {"ID": 1, "Name": "Kabul", "code": "AFG",, "District": "Kabol", "Population": 1780000},
    {"ID": 2, "Name": "Qandahar", "code": "AFG",, "District": "Qandahar", "Population": 237500},
    ...
]
Activité n°11 : Ouverture et chargement des fichiers CSV
import csv

# Chargement du fichier countries.csv
pays = []
with open("countries.csv", encoding="utf-8") as f:
    donnees = csv.DictReader(f, delimiter=',')
    for row in donnees:
        pays.append(row)
print(pays)

# Chargement du fichier languages.csv
langues = []
with open("languages.csv", encoding="utf-8") as f:
    donnees = csv.DictReader(f, delimiter=',')
    for row in donnees:
        langues.append(row)
print(langues)

# Chargement du fichier cities.csv
villes = []
with open("cities.csv", encoding="utf-8") as f:
    donnees = csv.DictReader(f, delimiter=',')
    for row in donnees:
        villes.append(row)
print(villes)
Activité n°12 : Rechercher les langues parlées en Haïti
🎯 Quelles sont les langues parlées en Haïti ? Pour le savoir il faut :
-
parcourir la liste pays jusqu'à trouver le code de Haïti (orthographié Haiti dans la liste pays),
-
parcourir la liste langues et en extraire les valeurs correspondant à ce code.
Langues parlées en Haïti
Compléter le code ci-dessous permettant de déterminer les langues parlées en Haïti.
i_haiti = 0
while pays[i_haiti]["Name"]... "Haiti":
    i_haiti = ...

code = pays[i_haiti][...]

langues_haiti = []
for entree in langues:
    if entree[...] == code:
        langues_haiti.append(entree)

for langue in langues_haiti:
    print(langue)
Activité n°13 : Trouver la langue parlée d’un pays
Le descripteur CountryCode permet donc de faire le lien entre les deux listes pays et langues. Utilisons cette relation afin de déterminer les langues parlées dans un pays quelconque.
Langues parlées dans un pays
On demande d'écrire deux fonctions :
-
code_pays prend en argument la liste des pays ainsi que le nom d'un pays et renvoie son code ;
-
langues_parlees prend en argument les listes des données des pays et celle des langues (arguments pays et langues) ainsi que le nom d'un pays (nom) et renvoie la liste des noms des langues parlées dans ce pays.
Exemples :
>>> code_pays(pays, "Haiti")
"HTI"
>>> langues_parlees(pays, langues, "Haiti")
['French', 'Haiti Creole']
def code_pays(pays, nom):
    """Renvoie le code d'un pays"""
    ...


def langues_parlees(pays, langues, nom):
    """Renvoie la liste des noms des langues parlées dans le pays indiqué par son nom"""
    ...

assert sorted(langues_parlees(pays, langues, "Haiti")) == ['French', 'Haiti Creole']
Activité n°14 : Trouver la capitale d’un pays
🎯 Quelle est la capitale d'Haïti ? Là encore, il faut :
-
parcourir la liste des pays jusqu'à trouver l'entrée correspondant à Haïti,
-
repérer le code de la capitale correspondante,
-
parcourir la liste des villes jusqu'à trouver le code cherché.
Nous allons effectuer ces actions pour chacun des pays présents dans la liste. La capitale étant trouvée, nous ajouterons une nouvelle clé CapitalName au dictionnaire du pays. La valeur associée sera le nom de la capitale obtenu.
Certains des « pays » listés n'en sont pas vraiment et n'ont donc pas de capitale. C'est par exemple le cas de l'Antarctique. Lors de l'import des données, on leur a associé la valeur -1 à la clé Capital.
Associer les capitales aux pays Compléter le code ci-dessous afin d'ajouter à chaque dictionnaire correspondant à un pays une nouvelle entrée CapitalName contenant le nom de sa capitale. On utilisera la chaîne vide "" comme valeur pour les « pays » sans capitale.
Ainsi :
-
le dictionnaire correspondant à la France contiendra un nouveau couple "CapitalName": "Paris",
-
celui de l'Antarctique "CapitalName": "".
# a compléter
print(f"La capitale de la {pays[72]['Name']} est {pays[72]['CapitalName']}.")
Merci à Nicolas Revéret
6. Projet (démarche d’investigation)
⚓︎
projet 1 : ★ pandy pandas pas à pas
🧠 Exercices dans Capytale => le code vous sera donné par votre enseignant
On trouve énormément de données au format CSV sur internet. Une partie de ces données sont publiques, par exemple le site data.gouv.fr récence un grand nombre de données publiques. Ces données sont librement réutilisables.
Voici un exemple du contenu d'un fichier CSV :
nom,prenom,date_naissance
Durand,Jean-Pierre,23/05/1985
Dupont,Christophe,15/12/1967
Terta,Henry,12/06/1978
1 Donner les différentes valeurs du descripteur "date_naissance".
Les données structurées au format CSV
2 Afin de découvrir ce qu'est "l'open data", se rendre sur le site data.gouv.fr . En haut et à gauche de la page d’accueil, cliquer sur "Découvrez L’OpenData". Résumer en quelques lignes ce que vous aurez appris en lisant cette page.
3 Explorer pendant quelques minutes le site data.gouv.fr . Rechercher les données "Opérations coordonnées par les CROSS" à l'aide du moteur de recherche proposé par le site. Quel est le format proposé dans les fichiers principaux ?
4 on va travailler sur le fichier ident_virgule.csv (pour ceux sur Thonny :du dossier Ressources), le séparateur est la "virgule". Dans un tableur type libre offiche on obtient :
Les données sont bien "rangées" dans un tableau avec des lignes et des colonnes (voilà pourquoi on parle de données tabulaires).
5 on va travailler avec villes_virgule.csv (pour Thonny : du dossier Ressources)
On obtient 12 colonnes (et 36700 lignes si on ne compte pas l'entête !), voici la signification de ces colonnes :
- dep : numéro de département
- nom : nom de la commune
- cp : code postal
- nb_hab_2010 : nombre d'habitants en 2010
- nb_hab_1999 : nombre d'habitants en 1999
- nb_hab_2012 : nombre d'habitants en 2012 (approximatif)
- dens : densité de la population (habitants par kilomètre carré)
- surf : superficie de la commune en kilomètre carré
- long : longitude
- lat : latitude
- alt_min : altitude minimale de la commune (il manque des données pour certains territoires d'outre-mer)
- alt_max : altitude maximale de la commune (il manque des données pour certains territoires d'outre-mer)
Le traitement des données structurées
6 Executer le code Python suivant :
import pandas

ident = pandas.read_csv("ident_virgule.csv")
print(ident)
Le code ci-dessus est très simple :
- Avec la première ligne, import de la bibliothèque pandas afin de pouvoir l'utiliser
- À la deuxième ligne, création d’une variable "ident" qui va contenir les données présentes dans le fichier "ident_virgule.csv"
- La troisième ligne affiche les données contenues dans la variable "ident" rangées sous la forme d'un tableau, un peu comme ce que nous obtenions en ouvrant le fichier "ident_virgule.csv" avec un tableur.
Une colonne a été ajoutée par rapport à ce que nous obtenions avec le tableur :
Les nombres présents dans cette colonne sont appelés des index. Chaque ligne du tableau a un index (première ligne : index 0, deuxième ligne index 1...)
Les colonnes possèdent également des index, dans notre exemple ces index correspondent au "nom" (index de la première colonne), au "prenom" (index de la deuxième colonne) et à "date_naissance" (index de la troisième colonne)
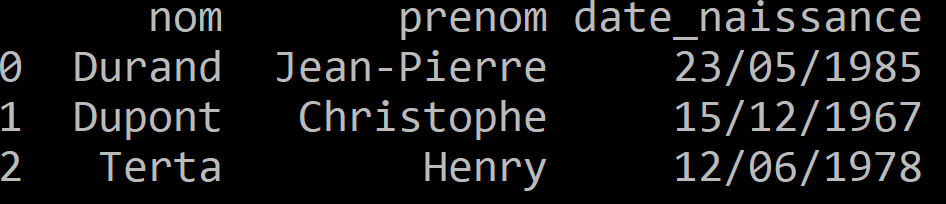 En résumé : les lignes possèdent des index (0,1,2..), les colonnes possèdent aussi des index ("nom", "prenom", …).
7 Il est possible de récupérer certaines données du tableau, par exemple, certaines lignes, certaines colonnes ou bien encore des valeurs uniques. Pour cela, il suffit d'utiliser l'instruction "loc" avec les index des lignes et les index des colonnes. Le principe de fonctionnement de "loc" est relativement simple puisque l'on aura une instruction de la forme "loc[index_ligne,index_colonne]"
import pandas

ident = pandas.read_csv("ident_virgule.csv")
print(ident)

info  = ident.loc[1, 'prenom']
print(info)
8 Recopier et modifier le programme pour que la variable info affiche "12/06/1978".
9 Il est possible de récupérer plusieurs toutes les lignes d'une colonne, il suffit de remplacer la partie "index_ligne" de "loc" par ":" (pour faire un slicing):
import pandas

ident = pandas.read_csv("ident_virgule.csv")
info  = ident.loc[:, 'prenom']
print(info)
10 Il est aussi possible de récupérer seulement certaines lignes et certaines colonnes en utilisant la notation suivante : loc[[index_ligne_1,index_ligne_2,...],[index_colonne_1,index_colonne_2,…]] :
import pandas

ident = pandas.read_csv("ident_virgule.csv")
info  = ident.loc[[0,1], ['nom','date_naissance']]
print(info)
Afin d'avoir des exemples plus complexes à traiter, on travaille dans la suite sur les données contenues dans le fichier ville_virgule.csv.
Les descripteurs de ce fichier sont :
| dep | nom | cp | nb_hab_2010 | nb_hab_1999 | nb_hab_2012 | dens | surf | long | lat | alt_min | alt_max |
11 Tester le programme suivant :
import pandas

info_villes = pandas.read_csv("villes_virgule.csv")
print(info_villes)
Vérifier que la variable "info_villes" contient bien les données contenues dans le fichier ville_virgule.csv. Il manque des données dans le tableau qui s'affiche dans la console (les données manquantes sont symbolisées par des …). En effet, le tableau contient trop données pour qu'il soit entièrement affiché dans la console.
En explorant le tableau, on devrait, notamment dans les colonnes l'altitude mini et maxi, voir apparaître un étrange "NaN" (Not a Number) pour les dernières villes du tableau car certaines données sont manquantes.
Maintenant, pour obtenir un tableau contenant toutes les villes qui ont une altitude minimum supérieure à 1500 m, on va devoir introduire des conditions dans la sélection des villes.
12 Tester le programme suivant :
import pandas

info_villes = pandas.read_csv("villes_virgule.csv")
nom_alt = info_villes.loc[info_villes["alt_min"] > 1500, ["nom","alt_min"]]
print(nom_alt)
Dans la fonction "loc", l'expression "info_villes["alt_min"]>1500" est bien avant la virgule, elle concerne donc les index des lignes du tableau. On sélectionnera uniquement les lignes qui auront la valeur du descripteur "alt_min" supérieure à 1500. Nous allons donc bien sélectionner les villes qui ont une altitude minimum supérieure à 1500 m.
13 Écrire un programme qui permet d'avoir les villes qui ont une densité d'habitant (descripteur : "dens") inférieure à 50 (dans le tableau ainsi créé, on aura 3 colonnes : le nom de la ville, la densité de la population et l'altitude minimum)
14 Il est possible de combiner plusieurs facteurs de sélection en utilisant un "et"("&") ou un "ou"("|") :
import pandas

info_villes = pandas.read_csv("villes_virgule.csv")
nom_alt = info_villes.loc[(info_villes["alt_min"] > 1500) \
    & (info_villes["dens"] > 50), ["nom","dens","alt_min"]]
print(nom_alt)
Il y a, en France, une seule ville avec une densité de population inférieure à 2 et une altitude minimum supérieure à 1600 m. Donner son nom.
15 Il est aussi possible d'effectuer des calculs sur des colonnes, par exemple des moyennes. Il suffit d'utiliser l'instruction "mean" pour effectuer une moyenne :
import pandas

info_villes = pandas.read_csv("villes_virgule.csv")
moyenne_alt_min = info_villes.loc[:,"alt_min"].mean()
print(moyenne_alt_min)
On rappelle que dans "loc[:,"alt_min"]" le ":" signifie que l'on considère toutes les lignes du tableau. De plus le "alt_min" que le calcul de la moyenne porte bien sur les données du descripteur "alt_min".
16 Écrire un programme permettant de calculer le nombre moyen d'habitants en 2012
17 Pour l'instant nous avons calculé une moyenne sur l'ensemble des lignes, il est aussi possible d'imposer une condition sur les lignes qui seront utilisées pour le calcul :
import pandas

info_villes = pandas.read_csv("villes_virgule.csv")
nombre_hab = info_villes.loc[info_villes["alt_min"] > 1500, \
    "nb_hab_2012"].mean()
print(nombre_hab)
On constate que les villes ayant une altitude minimum supérieure à 1500 m avaient en moyenne 350 habitants en 2012.
18 Il est aussi possible de trier le tableau en fonction des valeurs d'un descripteur. Il suffit d'utiliser l'instruction "sort_values" :
import pandas
info_villes=pandas.read_csv("villes_virgule.csv")
tri_alt_min=info_villes.sort_values(by=["alt_min"])
print(tri_alt_min)
On obtient un nouveau tableau de données "tri_alt_min" trié dans l'ordre croissant des altitudes minimums. Donner la ville ayant l'altitude minimum la plus faible de France.
19 Il est aussi possible de trier par ordre décroissant en ajoutant "ascending=False"
import pandas

info_villes = pandas.read_csv("villes_virgule.csv")
tri_alt_min = info_villes.sort_values(by=["alt_min"], ascending=False)
print(tri_alt_min)
Indiquer la ville ayant l'altitude minimum la plus importante de France.
20 Écrire un programme permettant de répondre à la question suivante de façon très facile : quelle est la ville ayant la densité de population la plus forte ?
Il est possible de fusionner 2 tableaux de données qui ont une colonne commune.
Afin de travailler sur cette fusion, nous allons utiliser 2 fichiers au format CSV : fiches_client.csv et fiches_com.csv.
21 (pour Thonny, copier les 2 fichiers ci-dessus dans le dossier Documents), tester le code suivant :
import pandas

client = pandas.read_csv("fiches_client.csv")
commande = pandas.read_csv("fiches_com.csv")

print(client)
print("--")
print(print(commande))
Nous avons un tableau qui référence les clients (nom, prénom, ville), chaque client possède un numéro de client. Le deuxième tableau référence des commandes : pour chaque commande, nous avons un numéro de commande, une date et le numéro du client qui a passé la commande, ce numéro de client correspond évidemment au numéro de client que l'on trouve dans le premier tableau.
22 Sachant que nous avons deux colonnes contenant les mêmes types d'information (numéros de client), nous allons pouvoir fusionner les deux tableaux en un seul :
import pandas

client = pandas.read_csv("fiches_client.csv")
commande = pandas.read_csv("fiches_com.csv")

cmde_client = pandas.merge(client, commande)
print(cmde_client)
Prenons l'exemple de Mme Julie Gabriaux qui habite à Bordeaux (n° de client 2454) et de la commande effectuée le 02/02/2012 par le client ayant le n° 2454 (commande n° 45). La cliente qui a passé cette commande n° 45 est bien Mme Gabriaux, nous avons une ligne dans notre tableau "cl-com" :

Nous avons bien fusionné les 2 tableaux "client" et "commande" en un seul tableau "cl_com" qui regroupe les informations pour chaque commande. Quand on effectue ce genre de fusion, on dit souvent que l'on effectue une jointure.
23 Il faut prendre garde à l'ordre des arguments de la fonction "merge" :
import pandas

client = pandas.read_csv("fiches_client.csv")
commande = pandas.read_csv("fiches_com.csv")

cmde_client = pandas.merge(commande, client)
print(cmde_client)
Comme vous pouvez le constater, l'ordre des colonnes est différent. Il faudra donc être attentif à l'ordre des paramètres de la fonction "merge".
24 Mme Élodie Gaulin (n° de client 895) bien que présente dans le tableau "client", est absente du tableau "com_cl" (ou "cl_com"). Dire pourquoi.
25 De la même manière, aucun trace de la commande n° 1324 du 01/02/2017 dans le tableau "com_cl" (ou "cl_com"). Dire pourquoi.
projet 2 :★★ Qualité de l’air
🧠 Exercices dans Capytale => le code vous sera donné par votre enseignant
La ville de Digne, en association avec les petits débrouillards du 04 a initié une campagne de mesures de la qualité de l’air. Ces mesures sont issues des 4 stations répartis dans le centre-ville de Digne-les-Bains.
Les stations de qualité de l’air sont connectées et ont été réalisées par les élèves du Lycée Pierre Gilles de Gennes dans le cadre du projet Data'Digne. Ces capteurs ont une vocation pédagogique et citoyenne sur la pollution atmosphérique.
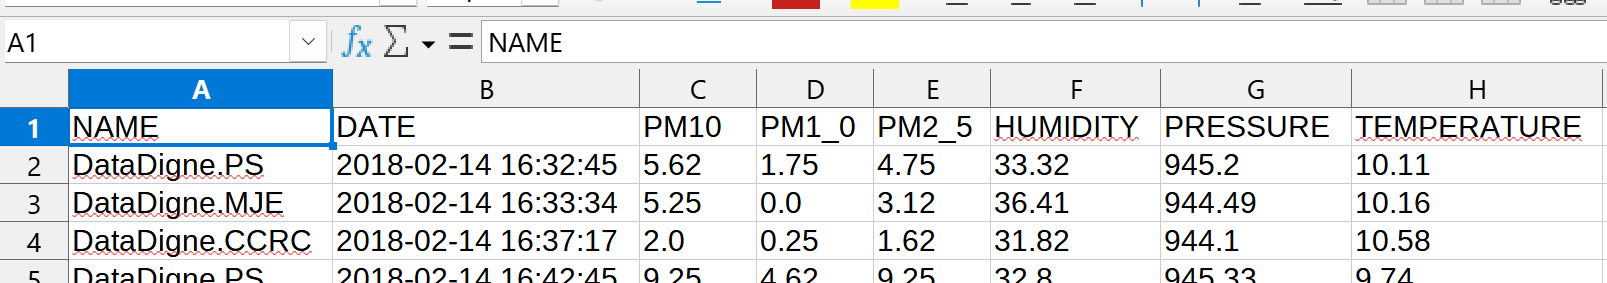
Le fichier fourni permet de connaître la concentration dans l’air des particules fines PM10, PM2.5 et PM1 ainsi que le taux d’humidité, la pression atmosphérique et la température sur une année. Le fichier est composé de 78 986 lignes. La mise à jour du fichier est annuelle, le fichier le plus récent remplace le précédent.
Pour des mesures de qualité de l’air à vocation non pédagogique, rendez-vous sur https://www.atmosud.org/
Récupération dans un fichier d’une seule journée d’enregistrement
On désire exploiter fichier des mesures 2018 fourni au format CSV. On souhaite en particulier voir l’évolution des mesures sur la journée choisie par l’utilisateur, conformément au graphe ci-contre. Pour cela on va décomposer le programme en fonctions élémentaires que l’on validera avant de passer à la suite.
Pour ceux qui travaille sur Thonny : On complétera le programme air_quality.py à l’aide de l’objet Python csv.
Voici une image du fichier :
1 Écrire une fonction qui enregistre uniquement les mesures sur une date précise dans un fichier CSV ayant comme nom digne-année-mois-jour.csv, où année, mois et jour seront saisies interactivement par l’utilisateur sous la forme jour/mois/année.
On donne le prototype suivant :
create_daily_list(input_file : str, output_file : str, date : str) -> list
input_file-- fichier en entréeoutput_file-- fichier en sortiedate-- date pur filtrage de données- la fonction retourne les enregistrements de la jouréne sélectionnée si OK ou None si erreur
Aide :
- l’ouverture du fichier d’entrée utilisera la virgule comme delimiter
-
l’ouverture du fichier de sortie sera codée :
new_file = open(output_file, 'w', newline='', encoding='utf-8') -
la date sera entrée sous la forme ‘01/04/2018’. On pourra séparer le jour, le mois et l’année avec la méthode split('/')
- la même date peut apparaitre sur plusieurs lignes
- attention la date sur le fichier CSV est notée 2018-04-01 et est contenu dans la colonne 1 donc pour pouvoir comparer la date entrée avec la date sur le fichier CSV il faut donc ne sélectionner que le début jusqu’à l’heure et changer l’affichage. On écrira :
if row[1].split(' ')[0] == year+"-"+month+"-"+day :
NB : on utilisera les méthodes reader, writer et writerow de l’objet Python csv.
2 Tester la fonction pour le 01/04/2018.
Résultat attendu :
[['DataDigne.PS', '2018-04-01 00:01:49', '1.12', '0.0', '1.12', '50.93', '937.13', '8.08'], ['DataDigne.HDV', '2018-04-01 00:06:27', '0.5', '0.0', '0.5', '48.5', '935.01', '8.15'], ['DataDigne.CCRC', '2018-04-01 00:08:10', '0.0', '0.0', '0.0', '46.0', '935.9', '9.61'], ['DataDigne.PS', '201 ...
3 Le tableau précédent ne contient pas de ligne d’entêtes. On va donc la rajouter L’idée est de mettre une condition qui ne fonctionne qu’une seule fois pour la première ligne que l’on ajoutera à la liste puis la condition n’étant plus respectée on ajoute les autres lignes à la liste.
4 Documenter la fonction
Création d’une liste de valeurs classées par heures, sur une journée
5 ★** ★** ★** On veut écrire une fonction qui renvoie une liste de mesures pour chaque heure. Chaque liste contient les valeurs mesurées correspondant à une colonne (un type de mesure) pour l’heure concernée. Le prototype de la fonction est le suivant :
create_hourly_values_list(output_file : str, colunm : str) -> list
- output_file -- fichier en sortie (fonction précédente fichier CSV déjà sélectionné par jour)
- colunm -- entête de colonne pour sélectionner la mesure souhaitée
- la fonction retourne une liste contenant 24 listes (une pour chaque heure) avec les mesures correspondantes (par exemple la température) si ok, ou None si erreur
Résultat attendu avec la température
[[8.08, 8.15, 9.61, 7.92, 8.17, 9.35, 7.33, 7.83, 9.57, 7.48, 7.54, 10.0, 7.49, 7.53, 9.59, 7.18, 7.41, 9.74], [7.04, 6.95, 9.0, 6.76, 6.9, 9.73, 6.5, 6.67, 9.3, 6.26, 6.66, 9.28, 6.46, 6.54, 9.05, 6.53, 6.7, 8.83], [6.19, 6.55, 9.01, 6.16, 6.04, 8.4, 6.13, 6.01, 8.77, 5.79, 6.05, 8.25, 6.12, 6.2, 8.26, 5.77, 6.37, 8.08], [5.69, 6.49, 8.24, 6.48, 5.98, 8.14, 5.91, 6.28, 8.43, 6.23, 6.39, 7.85, 6.14, 6.42, 8.3, 6.01, 6.13, 6.8], [6.29, 5.79, 6.59, 5.49, 5.43, 5.72, 5.82, 5.31, 5.93, 5.72, 5.44,…
- on utilisera la même méthode que précédemment pour mettre la ligne d’en-tête sur la liste
- pour récupérer l’heure
hour, min, sec = row[1].split(' ')[1].split(':')
- on créera une liste de 24 listes vides à l’aide de la compréhension de liste.
- Si vous avez converti les mesures en float, comme c’est souhaitable, une erreur apparaît car certains champs sont vides. D’autres peuvent contenir tout autre chose.
- Traiter les problèmes de conversion à l’aide d’une exception.
La fonction est déjà créée au-dessus si vous n’y arrivez pas copier là en dessous de la fonction create_daily_list
Création d’une liste de valeurs horaires moyenne pour une journée
On souhaite obtenir la valeurs moyenne des mesures heure par heure. Pour cela, on va écrire une fonction qui prend en paramètre la liste retournée par la fonction create_hourly_values_list. Pour rappel, cette liste contient 24 listes, chacune des listes contient les valeurs de mesures pour une heure donnée.
6 ★** ★** Écrire la fonction dont on donne le prototype :
create_hourly_averages_list(hourly_values_list : list) -> list
-
hourly_values_list-- liste de 24 listes contenant chacune les valeurs numériques (de type float) pour l'heure concernée -
la fonction retourne la liste des 24 moyennes horaires
Aide :
- Pour limiter l’impact des erreurs de mesures, on souhaite supprimer au préalable la valeur min et la valeur max de la liste des mesures effectuées chaque heure.
- on pourra appeler une fonction interne qui effectue ce calcul avec les fonctions built_in de Python (sum, max et min).
7 Documenter la fonction
Affichage des données
8 Ecrire un script qui permet de demander à l’utilisateur une date et qui retourne la moyenne par heure de cette date de « TEMPERATURE » en combinant les fonctions précédentes
On veut afficher l’évolution des valeurs journalières sous forme de graphe avec matlibplot. https://matplotlib.org/3.1.0/tutorials/index.html
9 Appeler la fonction show_plot() pour afficher les valeurs moyennes des températures sur 24 h.
projet 3 : ★ Pokémon
🧠 Exercices dans Capytale => le code vous sera donné par votre enseignant